목소리 샘플
독자적인 Foundation 모델
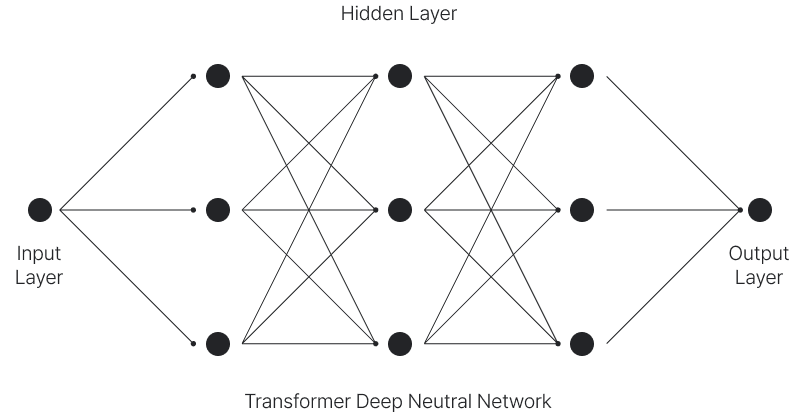
FRTTS는 Transformer 모델 기반의 Deep-Neural-Network (DNN) 모델입니다.
높은 퀄리티의 음질이 구현 가능한 자체 개발 엔진으로, 휴멜로에서 자체적으로 발전시킨 Foundation 모델입니다.
의미 기반 띄워읽기 등 자연스러운 발화가 가능하며, 영어와 한글의 혼용 등 어떠한 상황에서도 발화 가능합니다.
휴멜로 자체 개발 음성 초해상도화 기술

FRTTS의 특징
별도의 템플릿 대본 없이 음색 유사도와 감정 표현을 쉽게 복제
평범하지 않은 고음역대의 캐릭터 목소리, 저음의 배우 독백과 같은 특이한 보이스 복제도 가능합니다.
기존 업계가 요구하던 1시간의 보이스 데이터를 1분으로 대폭 슬림화
1분 보이스 데이터의 음색을 완벽하게 복제하여 TTS로 구현이 가능합니다.
풍성한 옵션을 통해 목소리 특징을 자유롭게 조절 가능
발화 속도, 발화 높낮이, 발화 음량 등을 딥러닝 모델을 통해 조절이 가능합니다. 단순 피치와 구간 변경이 아닌 모델의 추론을 통해 자연스러운 발화 조절을 제공합니다. 음소단위로 발화의 높낮이와 속도를 세밀하게 편집이 가능합니다.
5개 언어를 1분의 보이스 데이터와 학습 8시간에 가능
한국, 미국, 일본, 중국, 스페인 언어를 지원합니다.
보이스 학습도 8시간이면 완료
업계 평균 24시간 초과되는 학습시간을 대폭 줄였습니다.
다양한 오디오 포맷 지원
WAV, MP3, PCM, U-LAW, samplerate 및 bitrate 등의 다양한 오디오 포맷을 지원합니다.
실시간 보이스 생성 보장
30자 기준으로 보이스 0.3초 이하 지연시간이 발생되어 지연비용을 확 줄이세요.
보이스 초해상화 48kHz 데이터셋 확보
고품질 오디오 지원 (업샘플러). 저음질의 보이스를 고음질의 풍성한 보이스로 표현하세요.
자주 묻는 질문
도입하시고자 하는 환경과 조건(채널, 사용량 등)이 파악된 후 견적이 나오고 있어 먼저 도입문의를 통해 정보를 남겨 주시는대로 최대한 빨리 연락 드려 도움 드리도록 하겠습니다.
당연히 가능합니다. 먼저 고객사가 해결하고 싶은 문제를 정확히 진단 후 솔루션을 제안한 뒤 PoC 하실 수 있도록 도움 드리고 있습니다.
- FRTTS는 B2B 엔터프라이즈 도입 용도에 맞추어 개발된 커스텀 솔루션으로 실시간 합성과 대규모 트래픽에 최적화되어 있습니다.
- DIVE는 2초 보이스 데이터로 감정까지 합성하는 기업 전용 보이스 클로닝 솔루션으로, 다국어 목소리 복제와 상담 자동화 등에 활용됩니다.
FRTTS는 클라우드 API로 제공하며 설치형은 없습니다. 고객사 서버(온프레미스)에 설치해야 한다면 설치형으로 제공하는 DIVE 또는 DIVE Flex로 상담해 드립니다.
저희 휴멜로는 별도의 유지보수 계약을 통해 항상 최상의 품질을 경험할 수 있도록 책임감을 갖고 관리 업무에 임하고 있습니다.